Al desarrollar una aplicación solemos dar por sentado, quizá con demasiado optimismo, que todo funcionará. Esto ocurre especialmente cuando nos comunicamos con otros servicios o sistemas de terceros.
Suponemos que el servicio externo siempre estará disponible, que la red funcionará, que las respuestas llegarán rápido y que, una vez establecida la comunicación, todo seguirá funcionando igual.
Veamos un ejemplo sencillo:
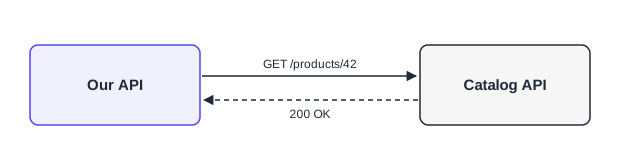
Normalmente, Catalog API responde en 100 ms y todo funciona perfectamente.
Pero durante unos segundos Catalog API devuelve 503 Service Unavailable. O tarda ocho segundos en responder, deja de responder por completo o se ve desbordada cuando nuestra aplicación recibe diez veces el tráfico previsto.
Una dependencia puede dejar de estar disponible, responder despacio o sobrecargarse. Debemos diseñar el sistema sabiendo que, tarde o temprano, esto ocurrirá.
Aquí entra en juego la resiliencia.
De gestionar errores a diseñar resiliencia
Lo primero que se nos ocurre es gestionar el error:
try
{
    var response = await catalogClient.GetAsync("/products/42");
    response.EnsureSuccessStatusCode();
}
catch (HttpRequestException ex)
{
    // Gestionar el error
}
Este código no tiene nada de malo, pero solo decide qué hacer después de que la operación haya fallado.
Crear una aplicación resiliente exige ir un paso más allá. Debemos preguntarnos:
- ¿Qué ocurre si la llamada falla?
- ¿Qué ocurre si el servicio responde lentamente?
- ¿Qué ocurre si sigue fallando?
- ¿Qué ocurre si enviamos demasiadas peticiones?
- ¿Qué ocurre si el fallo es temporal?
La resiliencia consiste en diseñar explícitamente cómo se comportará la aplicación ante los fallos: recuperarse cuando sea posible y, sobre todo, impedir que un problema en una dependencia se propague al resto del sistema.
Aquí es donde ayuda Microsoft.Extensions.Resilience.
Microsoft.Extensions.Resilience
Si llevas tiempo creando aplicaciones .NET resilientes, probablemente conozcas Polly, una de las bibliotecas más utilizadas en el ecosistema .NET para estrategias como reintentos, circuit breakers y timeouts.
Con .NET 8, Microsoft introdujo dos paquetes construidos sobre Polly v8: Microsoft.Extensions.Resilience y Microsoft.Extensions.Http.Resilience, como explica en su artículo sobre resiliencia en .NET 8.
Hoy disponemos de:
Microsoft.Extensions.Resilience, que ofrece mecanismos generales para crear e integrar pipelines de resiliencia.Microsoft.Extensions.Http.Resilience, que añade funciones específicas paraHttpClient.
El paquete anterior, Microsoft.Extensions.Http.Polly, está obsoleto. Microsoft recomienda los paquetes nuevos para aplicaciones nuevas; su documentación de resiliencia en .NET recoge las indicaciones actualizadas.
Si ya conoces Polly, el modelo conceptual te resultará familiar, pues los paquetes de Microsoft se basan en él. Antes de ver el código, conviene entender qué problemas resuelven estas estrategias.
Un resumen de las estrategias
Una pipeline de resiliencia es una secuencia de estrategias que rodean la operación que queremos ejecutar.
Para una llamada HTTP, podemos imaginarla así:
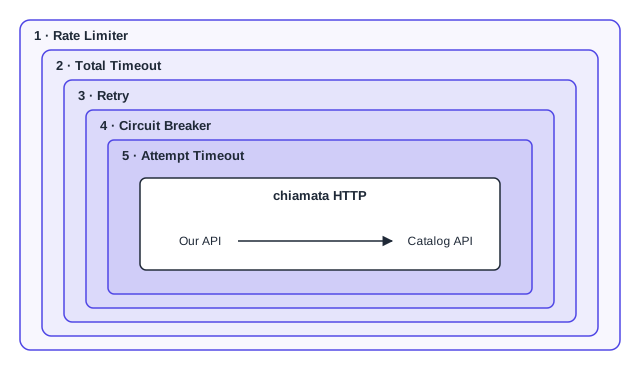
Esta es la pipeline estándar que proporciona Microsoft.Extensions.Http.Resilience. Por orden, contiene un limitador de concurrencia, un timeout global, una estrategia de reintentos, un circuit breaker y un timeout para cada intento.
Por ahora basta con entender la función de cada estrategia:
- El rate limiter controla cuántas operaciones pueden ejecutarse a la vez contra la dependencia. Su valor predeterminado es de 1000 operaciones concurrentes, sin cola. Su objetivo es evitar una presión excesiva sobre el servicio.
- El total timeout limita la duración de toda la operación, incluidos los intentos posteriores.
- La estrategia de retry repite una operación cuando el fallo podría ser transitorio.
- El circuit breaker detiene temporalmente las llamadas cuando la tasa de fallos de una dependencia supera un umbral. Por defecto, ese umbral es el 10 % de las peticiones durante una ventana de 30 segundos, con un mínimo de 100 peticiones.
- El attempt timeout limita la duración de cada intento individual.
La configuración puede ser sorprendentemente sencilla. Después de añadir el paquete:
dotnet add package Microsoft.Extensions.Http.Resilience
basta una línea para añadir el handler estándar:
services
    .AddHttpClient("catalog", client =>
    {
        client.BaseAddress = new Uri("https://catalog.example.com");
    })
    .AddStandardResilienceHandler();
AddStandardResilienceHandler() asocia la pipeline estándar a nuestro HttpClient. Sin embargo, añadir esa línea por sí sola no convierte mágicamente en resiliente a cualquier aplicación.
Reintentar no siempre es buena idea
Supongamos que recibimos 503 Service Unavailable. El problema podría ser temporal, así que reintentar puede tener sentido.
Si recibimos 400 Bad Request, esperar un segundo y enviar la misma petición difícilmente cambiará el resultado. La pipeline estándar no la reintenta: las estrategias de retry y circuit breaker gestionan errores 5xx, 408 Request Timeout, 429 Too Many Requests, HttpRequestException y timeouts.
El caso de un POST /payments no idempotente es más delicado. Si no sabemos si el primer intento se procesó, repetirlo automáticamente podría provocar dos pagos.
La pipeline estándar no nos protege aquí. Por defecto, reintenta peticiones hechas con cualquier método HTTP, incluido POST. Si nuestro cliente realiza operaciones no idempotentes, debemos configurarlo explícitamente:
services
    .AddHttpClient("payments", client =>
    {
        client.BaseAddress = new Uri("https://payments.example.com");
    })
    .AddStandardResilienceHandler(options =>
    {
        // Sin reintentos para POST, PUT, PATCH, DELETE ni CONNECT
        options.Retry.DisableForUnsafeHttpMethods();
    });
Cada estrategia de resiliencia tiene ventajas y costes. Incluso un reintento aparentemente inocuo genera tráfico adicional. Si cientos de instancias reintentan al mismo tiempo contra un servicio que ya tiene problemas, pueden empeorar la situación. La pipeline estándar reduce este riesgo con backoff exponencial y jitter, que distribuyen los intentos en el tiempo, y con un circuit breaker que deja de llamar a una dependencia claramente en dificultades. Reducir el riesgo no significa eliminarlo.
La resiliencia no consiste en reintentarlo todo. Consiste en entender qué fallo quieres gestionar y qué comportamiento buscas.
¿Y Polly?
Como Microsoft.Extensions.Resilience se basa en Polly, hay otro aspecto que conviene tener en cuenta.
En julio de 2026, Polly anunció que adoptaría la Open Source Maintenance Fee (OSMF). A partir del 16 de noviembre de 2026, la cuota anunciada es de 20 dólares al mes por organización para quienes cumplan los criterios del proyecto: al menos 20 000 dólares de ingresos procedentes de productos que utilicen Polly. El código sigue siendo de código abierto y la licencia de Polly no cambia.
Hay una distinción importante: según las preguntas frecuentes de OSMF para consumidores de software, la cuota afecta a las dependencias directas, pero no a las transitivas. Si usamos Microsoft.Extensions.Resilience sin referenciar Polly directamente, Polly sigue siendo una dependencia transitiva del paquete de Microsoft.
La distinción se refiere a los paquetes referenciados, no al código que escribimos. Usar tipos de Polly expuestos por los paquetes de Microsoft, como RetryStrategyOptions o el espacio de nombres Polly, no la altera. En cambio, añadir un PackageReference explícito a Polly.Core o Polly.Extensions convierte Polly en una dependencia directa.
Los equipos que referencien Polly directamente deberán evaluar su caso. Quienes lo utilicen de forma transitiva a través de Microsoft.Extensions.Resilience se encuentran en otra situación según las reglas de OSMF publicadas hasta ahora.
Volvamos a la resiliencia.
Resiliencia desde el diseño
Empezamos con una llamada HTTP sencilla. Al principio parecía que había poco que diseñar: enviamos una petición y recibimos una respuesta. Pero en cuanto dejamos de suponer que todo funcionará siempre, debemos decidir qué ocurre si la llamada falla, se ralentiza o ejerce demasiada presión sobre el servicio externo.
Una pipeline de resiliencia nos permite convertir esas preguntas en comportamientos explícitos de la aplicación.
La idea clave es:
Una aplicación resiliente no es una aplicación que nunca falla.
Es una aplicación diseñada sabiendo que, tarde o temprano, algo fallará.
En el siguiente artículo entraremos en una pipeline de resiliencia. Haremos fallar intencionadamente la llamada a Catalog API y veremos cómo se comportan los timeouts, los reintentos, los circuit breakers, el rate limiting y el hedging: cuándo utilizarlos y cuándo pueden empeorar la situación.