Quando sviluppiamo un’applicazione tendiamo spesso, forse con un eccesso di ottimismo, a dare per scontato che tutto andrà bene. Questo è particolarmente vero quando comunichiamo con altri servizi o sistemi di terze parti.
Diamo per scontato che il servizio esterno sia sempre disponibile, che la rete funzioni, che le risposte arrivino velocemente e che, una volta stabilita la comunicazione, tutto continui a funzionare nello stesso modo.
Prendiamo un caso molto semplice:
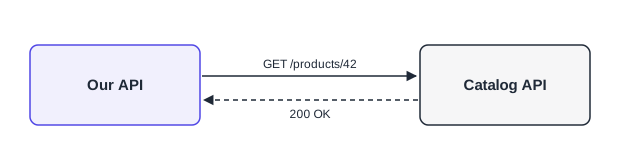
Normalmente Catalog API risponde in 100 ms e tutto funziona perfettamente.
Poi, per qualche secondo, Catalog API restituisce 503 Service Unavailable. Oppure impiega 8 secondi a rispondere, smette del tutto di rispondere o viene sommersa di richieste quando la nostra applicazione riceve dieci volte il traffico previsto.
Una dependency può diventare non disponibile, lenta oppure sovraccaricata. E il nostro sistema deve essere progettato sapendo che, prima o poi, succederà.
È qui che entra in gioco la resilienza.
Da fault handling a resilience
La prima soluzione che viene naturale è gestire l’errore.
try
{
    var response = await catalogClient.GetAsync("/products/42");
    response.EnsureSuccessStatusCode();
}
catch (HttpRequestException ex)
{
    // Handle error
}
Non c’è nulla di sbagliato, ma abbiamo semplicemente deciso cosa fare dopo che l’operazione è fallita.
Rendere resiliente un’applicazione significa fare un passo in più.
Dobbiamo iniziare a chiederci:
- Cosa succede se la chiamata fallisce?
- Cosa succede se il servizio è lento?
- Cosa succede se continua a fallire?
- Cosa succede se stiamo inviando troppe richieste?
- Cosa succede se il fallimento è solo temporaneo?
La resilienza consiste quindi nel progettare esplicitamente come l’applicazione deve comportarsi in presenza di failure, cercando dove possibile di recuperare e, soprattutto, evitando che il problema di una dependency si propaghi al resto del sistema.
Ed è qui che Microsoft.Extensions.Resilience viene in nostro soccorso.
Microsoft.Extensions.Resilience
Chi sviluppa applicazioni .NET resilienti da qualche anno probabilmente conosce già Polly, una delle librerie più diffuse nell’ecosistema .NET per implementare strategie come retry, circuit breaker e timeout.
Con .NET 8, Microsoft ha introdotto due nuovi package costruiti sopra Polly v8: Microsoft.Extensions.Resilience e Microsoft.Extensions.Http.Resilience, come spiega nell’articolo sulle novità di .NET 8.
Oggi abbiamo quindi:
Microsoft.Extensions.Resilience, che fornisce i meccanismi generali per costruire e integrare resilience pipeline.Microsoft.Extensions.Http.Resilience, che aggiunge funzionalità specifiche perHttpClient.
Il precedente package Microsoft.Extensions.Http.Polly è invece deprecato e Microsoft raccomanda di utilizzare i nuovi package per le nuove applicazioni. La documentazione sulla resilienza in .NET raccoglie le indicazioni aggiornate.
Per chi arriva da Polly il modello concettuale rimane familiare, anche perché i nuovi package Microsoft sono costruiti proprio sopra Polly. Prima di vedere il codice, però, conviene capire quali problemi possiamo risolvere.
Una panoramica delle strategie
Una resilience pipeline è una sequenza di strategie che avvolge l’operazione che vogliamo eseguire.
Nel caso di una chiamata HTTP possiamo immaginarla così:
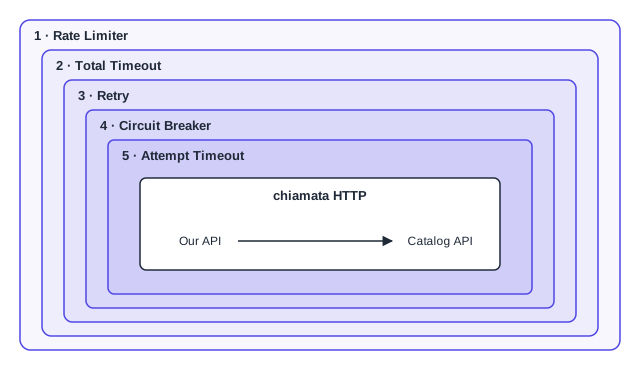
Questa è proprio la pipeline standard fornita da Microsoft.Extensions.Http.Resilience. Microsoft la compone, nell’ordine, con rate limiter, timeout complessivo, retry, circuit breaker e timeout del singolo tentativo.
Per ora ci basta capire a grandi linee il ruolo di ognuna.
Il rate limiter controlla quante operazioni possono essere eseguite contemporaneamente verso la dependency (di default 1000, senza coda). L’obiettivo è evitare di esercitare una pressione eccessiva sul servizio che stiamo chiamando.
Il total timeout definisce quanto tempo concediamo all’intera operazione, compresi eventuali tentativi successivi.
Il retry permette di eseguire nuovamente un’operazione quando il failure potrebbe essere transitorio.
Il circuit breaker interrompe temporaneamente le chiamate quando la percentuale di failure verso una dependency supera una soglia (di default il 10% delle richieste in una finestra di 30 secondi, con almeno 100 richieste).
L’attempt timeout limita invece il tempo concesso a ogni singolo tentativo.
E configurarli può essere sorprendentemente semplice. Dopo aver aggiunto il package:
dotnet add package Microsoft.Extensions.Http.Resilience
basta una riga:
services
    .AddHttpClient("catalog", client =>
    {
        client.BaseAddress = new Uri("https://catalog.example.com");
    })
    .AddStandardResilienceHandler();
AddStandardResilienceHandler() associa al nostro HttpClient proprio la pipeline standard appena vista.
Questo non significa, però, che sia sufficiente aggiungere quella riga per rendere magicamente resiliente qualsiasi applicazione.
Non sempre riprovare è una buona idea
Prendiamo il retry.
Se ricevessimo 503 Service Unavailable, il problema potrebbe essere temporaneo e ritentare l’operazione può avere perfettamente senso.
Ma se invece ricevessimo 400 Bad Request aspettare un secondo e inviare esattamente la stessa richiesta difficilmente cambierà il risultato. Infatti la pipeline standard non lo fa: retry e circuit breaker gestiscono solo gli errori 5xx, 408 Request Timeout, 429 Too Many Requests, le HttpRequestException e i timeout.
Ancora più interessante è il caso di POST /payments non idempotente. Se non sappiamo se il primo tentativo sia stato effettivamente processato, eseguire automaticamente la stessa operazione una seconda volta potrebbe significare effettuare due pagamenti.
E qui la pipeline standard non ci protegge: di default ritenta le richieste per qualsiasi metodo HTTP, POST compreso. Se il nostro client esegue operazioni non idempotenti, dobbiamo dirlo esplicitamente:
services
    .AddHttpClient("payments", client =>
    {
        client.BaseAddress = new Uri("https://payments.example.com");
    })
    .AddStandardResilienceHandler(options =>
    {
        // Nessun retry per POST, PUT, PATCH, DELETE e CONNECT
        options.Retry.DisableForUnsafeHttpMethods();
    });
Ogni strategia di resilienza introduce quindi anche dei trade-off.
Persino un retry apparentemente innocuo genera traffico aggiuntivo. Se centinaia di istanze iniziano contemporaneamente a effettuare retry verso un servizio già in difficoltà, possiamo contribuire noi stessi a peggiorare il problema. La pipeline standard mitiga questo rischio con un backoff esponenziale con jitter, che distribuisce nel tempo i tentativi, e con il circuit breaker, che smette di chiamare una dependency chiaramente in difficoltà. Ma mitigare non significa eliminare.
La resilienza, quindi, non significa riprovare sempre. Significa capire quale failure stiamo cercando di gestire e quale comportamento vogliamo ottenere.
E Polly?
Dato che Microsoft.Extensions.Resilience è costruito sopra Polly, vale la pena aprire una piccola parentesi.
Nel luglio 2026 Polly ha annunciato l’adozione dell’Open Source Maintenance Fee (OSMF). Dal 16 novembre 2026, per le organizzazioni che rientrano nei criteri indicati dal progetto (ricavano almeno 20.000 dollari da prodotti che utilizzano Polly), la Maintenance Fee annunciata è di 20 dollari al mese per organizzazione. Il codice continua comunque a essere open source e la licenza di Polly non cambia.
C’è però una distinzione importante: secondo le FAQ per chi usa software soggetto a OSMF, la fee riguarda le dipendenze dirette, non quelle transitive. Se utilizziamo Microsoft.Extensions.Resilience senza referenziare direttamente Polly, Polly rimane una dipendenza transitiva del package Microsoft.
Attenzione però: la distinzione riguarda i package referenziati, non il codice che scriviamo. Usare nel nostro codice tipi di Polly esposti dai package Microsoft, come RetryStrategyOptions o il namespace Polly, non la cambia. Aggiungere un PackageReference esplicito a Polly.Core o Polly.Extensions, invece, rende Polly una dipendenza diretta.
Chi utilizza Polly direttamente dovrà quindi valutare il proprio caso; chi lo utilizza transitivamente attraverso Microsoft.Extensions.Resilience si trova in una situazione differente secondo le regole OSMF attualmente pubblicate.
Chiusa la parentesi, torniamo alla resilience.
Resilience by design
Eravamo partiti da una semplice chiamata. A prima vista sembrava non esserci molto da progettare: mandiamo una richiesta, riceviamo una risposta. Ma appena smettiamo di assumere che tutto andrà sempre bene, dobbiamo decidere come comportarci se la chiamata fallisce, rallenta o mette sotto pressione il servizio esterno.
Una resilience pipeline ci permette di trasformare queste domande in comportamenti espliciti della nostra applicazione.
Il concetto chiave diventa quindi:
Un’applicazione resiliente non è un’applicazione che non fallisce.
È un’applicazione progettata sapendo che qualcosa, prima o poi, fallirà.
Nel prossimo articolo entreremo dentro una resilience pipeline.
Faremo fallire intenzionalmente la nostra chiamata a Catalog API e vedremo, passo dopo passo, come si comportano timeout, retry, circuit breaker, rate limiting e hedging, ma soprattutto quando utilizzarli e quando possono invece peggiorare la situazione.